
Desde que me juntei à Wave, tenho encontrado vários desafios extremamente interessantes. Começando pela adaptação a uma nova indústria (saí de fintech para telecom), ainda havia um novo processo de trabalho.
Nos projetos do cliente com o qual eu trabalho, ao preparar handoffs no Figma, era necessário pegar cada componente da interface e traduzir manualmente para a linguagem da nossa biblioteca interna, em que cada menor elemento da interface é um 'block' com propriedades e atributos específicos.
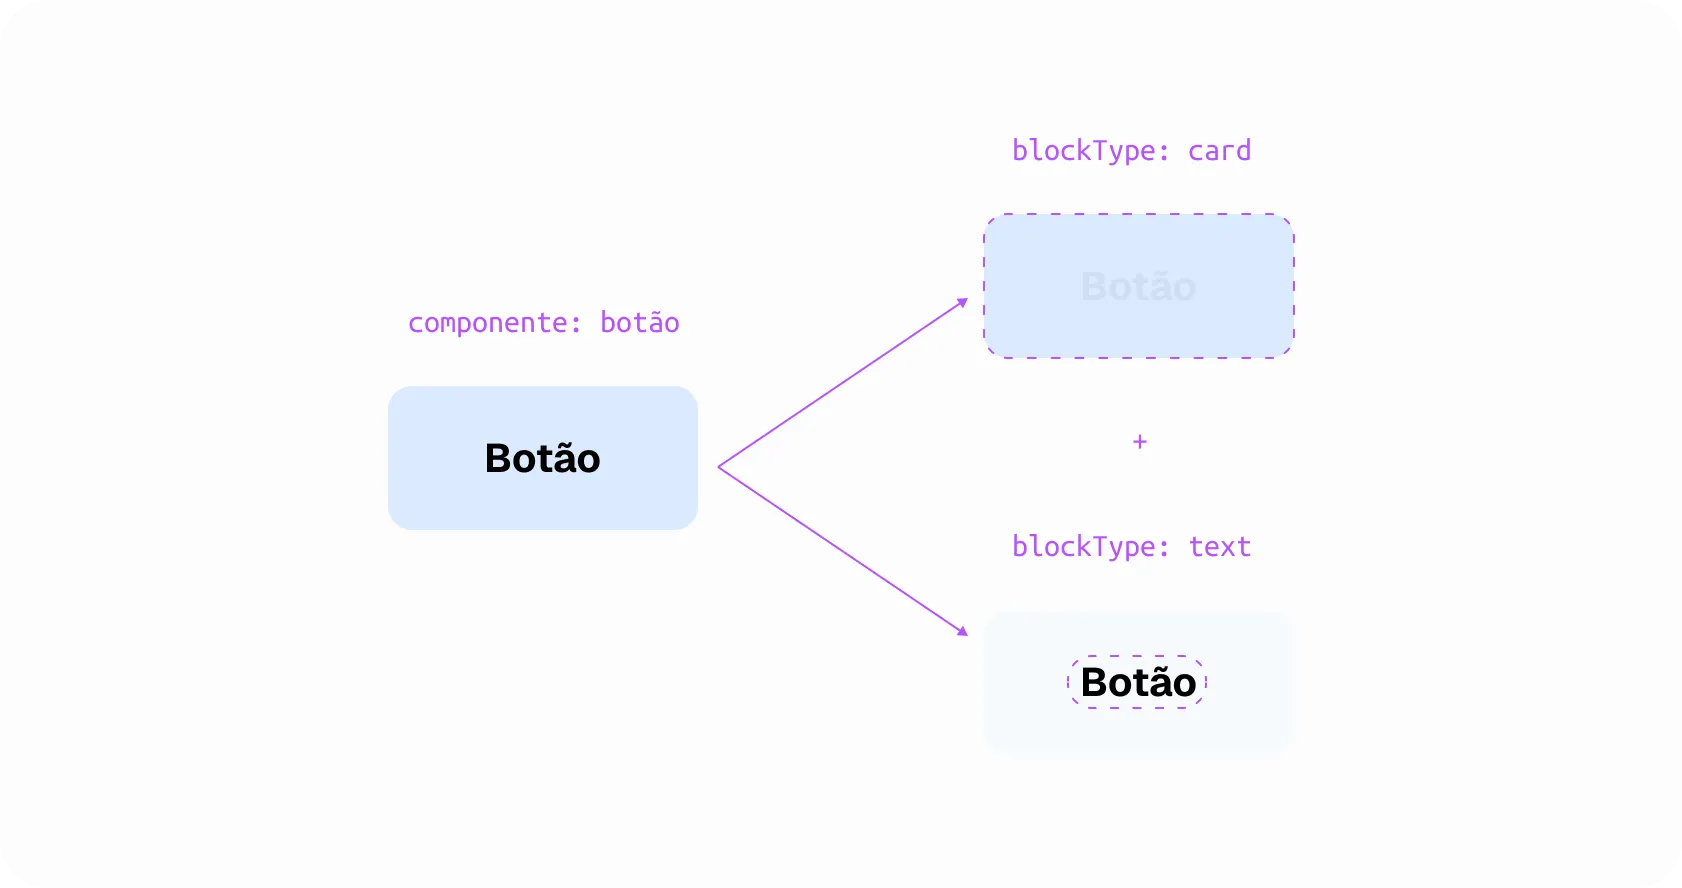
Então o processo era:
- Identificar quais blocks existiam em cada componente da interface
- Mapear as propriedades que cada block possui
- Documentar cada block com suas propriedades no Figma
- Compartilhar com os devs para que eles pudessem gerar os JSONs que iriam usar como base para a implementação.
Trabalho manual, repetitivo, mas muito necessário para garantir fluidez no desenvolvimento. No entanto, eu passava cerca de 36 horas semanais nesse processo. Quase nada mais cabia na semana.
Foi aí que comecei a pensar em como otimizar o processo para economizar tempo.
Por que “automatizar” não era a palavra certa
Meu primeiro instinto foi preparar uma documentação no próprio Figma e pedir ajuda aos devs para escrever um script capaz de automatizar a correspondência entre componentes do Figma e blocks.
O problema é que os dois sistemas funcionam com lógicas diferentes. No design system do cliente, um componente é uma unidade completa. Na nossa biblioteca, esse mesmo componente pode se quebrar em vários blocks ou simplesmente não ter equivalente nenhum. Não dá pra fazer uma correspondência direta.
Um script segue regras, mas o que eu precisava mesmo era de algo que interpretasse o contexto.
A partir dessa constatação, eu comecei a explorar uma orquestração de agentes utilizando o Claude. Não fiz isso porque dominava o conceito, mas porque entendia que aquele problema pedia uma solução que 'raciocinasse', em vez de apenas executar uma série de regras encadeadas.
Como os agentes “aprendem” a traduzir
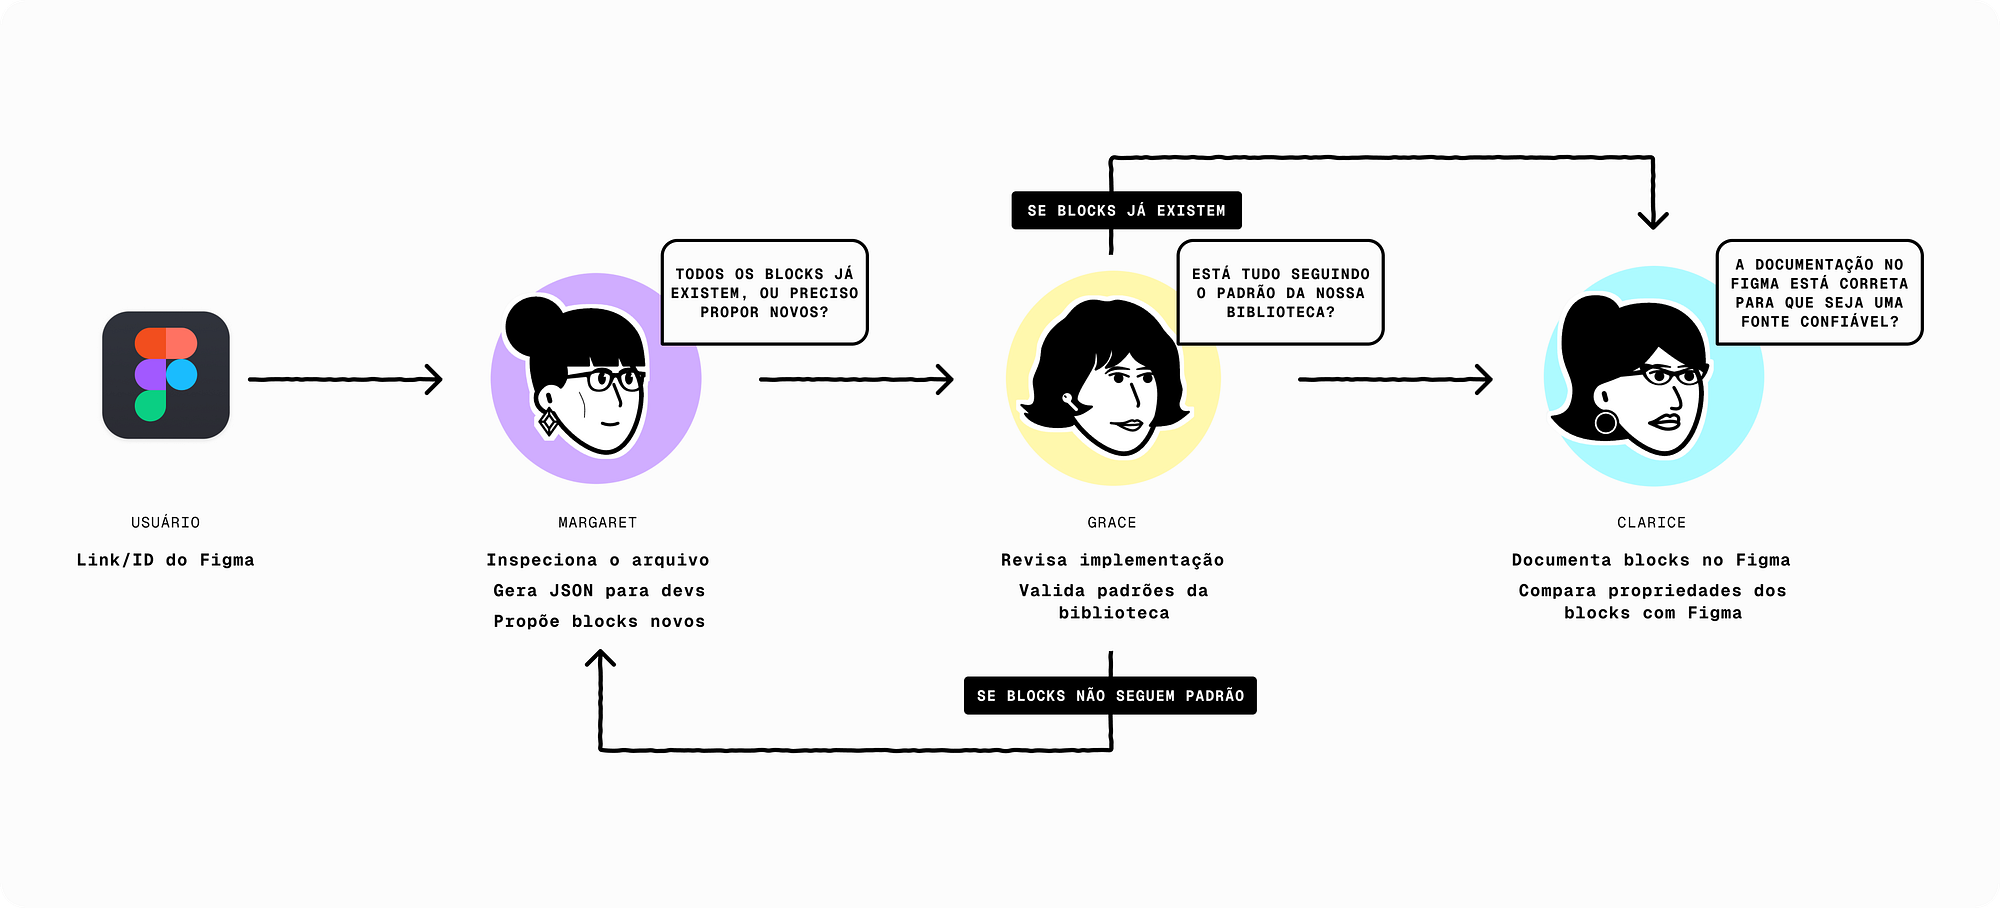
A lógica central é simples de entender: o orquestrador lê a nossa biblioteca inteira de blocks, com todas as propriedades, variantes e regras. Depois lê o componente do cliente. Então, em vez de tentar fazer uma correspondência direta de um para um, ele desmonta o componente do cliente até a menor unidade possível e tenta reconstruí-lo usando o vocabulário dos blocks.
Ele funciona como um tradutor que entende gramática, não como um dicionário que explica o que cada palavra significa.
O resultado é a representação da estrutura completa: o componente pai e todos os blocks filhos dentro dele, com as propriedades corretas no formato que eu escolher: documentação direta no Figma, ou um JSON pronto, no formato que os devs precisam para implementar.
Quando um block ou propriedade não existe na nossa biblioteca, o agente não ignora; ele sinaliza e documenta em uma planilha. Isso virou parte do processo e, mais tarde, teremos uma lista de gaps para avaliar e decidir se vale criar blocks novos dentro da nossa biblioteca ou pensar em outra abordagem.
Quatro problemas resolvidos de uma vez
Quando comecei a mapear o que precisava resolver, percebi que não era um problema. Eram quatro:
- Documentação no Figma: os componentes traduzidos são documentados automaticamente, seguindo o padrão da nossa API de blocks. O que antes eu demorava horas para fazer por componente, agora acontece em segundos.
- Mapeamento de gaps: quando algo não existe na biblioteca, o agente destaca. Nada cai no esquecimento.
- Geração de JSON: o arquivo que os devs usam como base para implementação é gerado com a estrutura completa, pai e filhos. Isso reduziu em 50% o trabalho do lado deles.
- SVGs limpos: alguns ícones do design system do cliente usavam máscaras que quebravam na implementação. Os agentes identificam quando isso acontece e removem essas máscaras e camadas ocultas, entregando arquivos SVG limpos e prontos para implementação.
O processo inteiro, da leitura da API à documentação final, acontece direto no Figma utilizando o plugin que também gerei com o Claude.
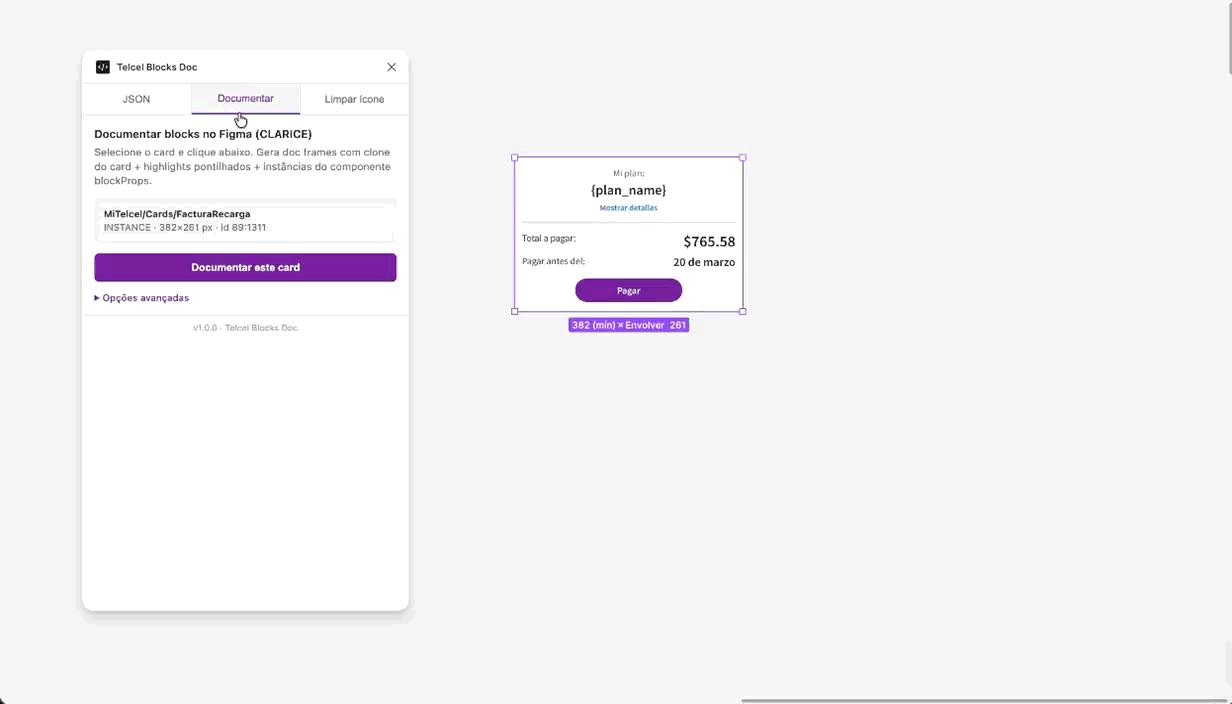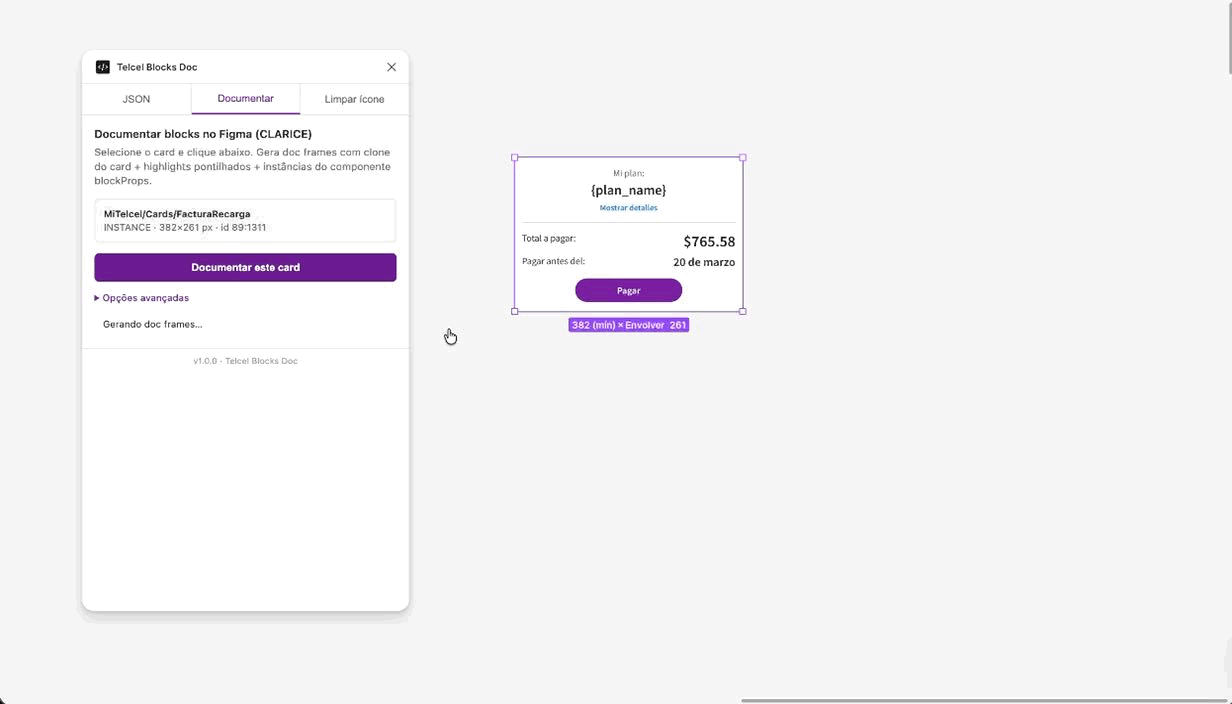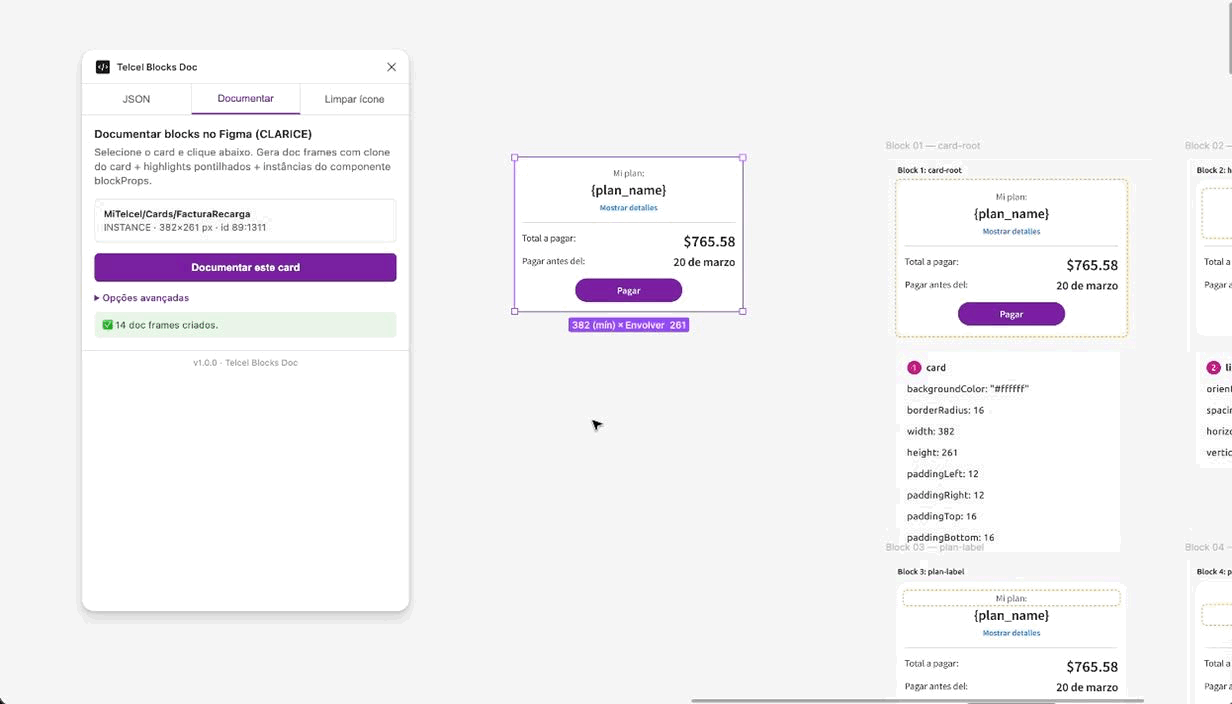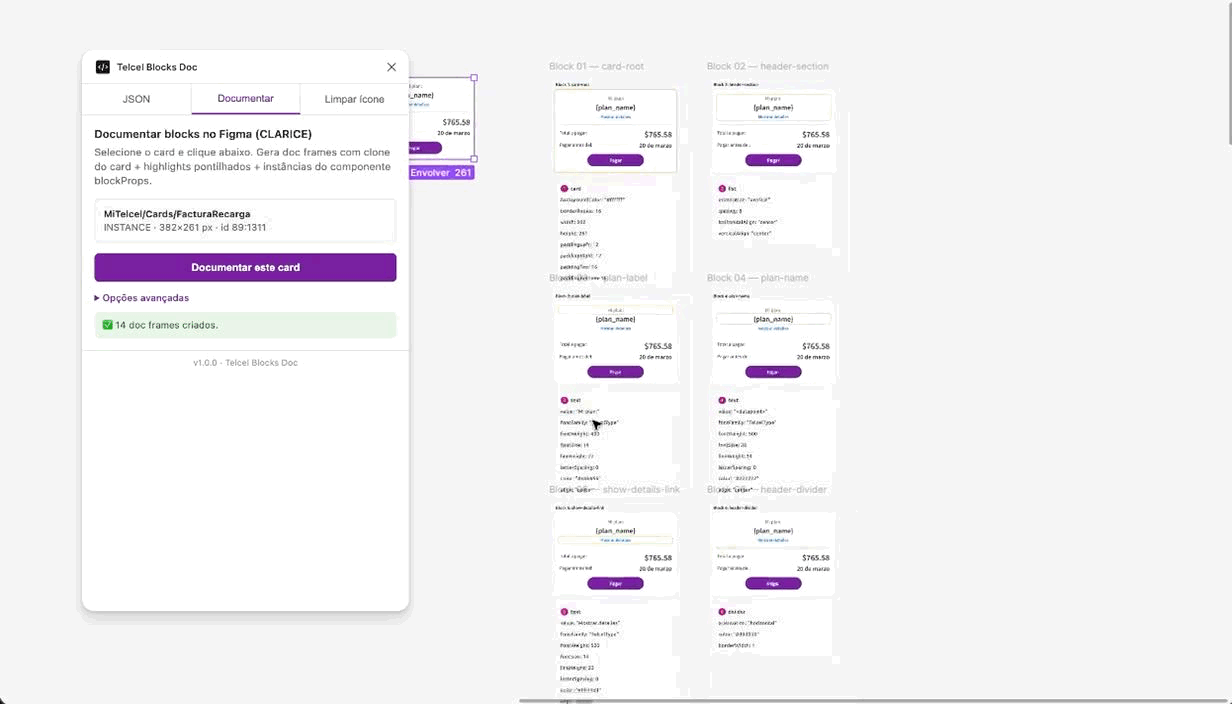
36 horas de volta
O que antes exigia quase a minha dedicação exclusiva durante a semana agora é feito em 1 hora, às vezes menos. Após gerar toda a documentação, eu reviso o output dos agentes, ajusto o que não foi encontrado na API e pronto. Isso mudou não só o meu trabalho, mas também me deu tempo para focar em outras tarefas e manter a qualidade das entregas.
Claro que os agentes erram. Não com frequência, mas erram especialmente em componentes muito customizados, onde a distância entre as duas linguagens é grande demais pra uma interpretação sem ruídos.
O caso mais frequente é um componente que usa o autolayout do Figma: quando o espaçamento entre elementos está definido como “auto”, por exemplo, o agente interpreta que auto = zero e os blocks aparecem colados quando o JSON é renderizado. É um erro pequeno, mas que aparece com regularidade suficiente pra estar no radar e, atualmente, ainda precisa ser corrigido manualmente.
A revisão humana ainda é parte do processo e penso que provavelmente sempre vai ser. O objetivo nunca foi eliminar a revisão do nosso time, mas otimizar e talvez eliminar, sim, o trabalho mecânico e repetitivo que consumia muito tempo em cada sprint.
Design de processo também é design ✨
Toda a orquestração foi construída com Claude. O que eu aprendi que é chave para viabilizar tudo é pensar bem no problema antes de escolher a ferramenta. Primeiro, definir as regras de comparação, a estrutura do output esperado, os casos de exceção. A IA fez o trabalho pesado, mas o design do processo foi 100% humano.
Publicado originalmente no Medium